每日新闻速览
DAILY NEWS REVIEW · 科技晨报
今日头条 Headlines
「不生成文本」的模型一周之间成了新类别:Jev 日处理 1 万亿 token、25% 财富 500 强在用,OpenAI、Databricks、Cloudflare、亚马逊在一周内全部交出同路线答卷
据《华尔街日报》10 月 5 日报道(DoNews 中文编译),初创公司 TypeSafe AI 于 9 月 15 日发布的模型 Jev 正在硅谷引发一场「大语言模型之外还有没有别的路」的讨论。Jev 的运行方式与聊天机器人完全相反:它不生成文本,而是把输入内容归入一组预先设定的输出——回答「是/否」、输出一个数值评分,或从既定列表里给出选择。这家公司把技术思路称作「面向校准决策的强化学习」(RLC),负责人迪奥戈·阿尔梅达曾在 OpenAI 参与 ChatGPT 研发。热度随之而来:大约一周前 Jev 日处理 token 数量已达一万亿;约 25% 的财富世界 500 强企业在用;TypeSafe 此前拿到 DCVC 的 4,000 万美元融资,上周《The Information》披露它正洽谈新一轮 10 亿美元级融资,部分意向估值已超 100 亿美元。更值得注意的是同类产品的密集跟进——一周内生成式模型阵营的大厂几乎全部交出了同路线工具,一个模型新类别正在成形。
- 机制拆解:Jev 与 Decider 2B 这一路的共同点,是把「输出空间」从无限的自然语言压缩到有限选项集,再用强化学习把选择行为校准到可靠。亚马逊 Strands Decider 2B 基于 Qwen3.5-2B 微调,只输出结构化决策、不生成文本,单次前向传播直接给出候选选项概率,本地 RTX 3090 上中位延迟 106 毫秒——「快、便宜、可复现」三个优势全部来自同一个来源:砍掉了自回归逐 token 生成的过程
- 为什么这件事发生在 Agent 时代(分析):阿尔梅达的判断很直白——主流 LLM「用于自动化场景时效果差得离谱」,不是不聪明,而是不可预测:软件需要一层稳定的、可以被上层反复调用的地基,聊天形态天然不是这种运行模式。而 Agent 工作流里恰好全是「下一步走哪条路」的高频决策点——路由、分类、审批、工具调用前的快判断,这些环节用 2B 参数的小模型就够了,复杂推理再交给生成式旗舰。如果这个分工被行业接受,那么 Agent 应用的成本结构会被改写:不是全线降价,而是「分桶后的大头(高频小决策)变便宜」
- 一周内的跟进密度(分析,见图):9 月 29 日 OpenAI 上线 Decisions API(依托 Luna 模型,答案限定在用户预设选项内),次日 Databricks 发布 ai_decide;10 月 1 日 Cloudflare 开源 Clef / Clef-flash(Qwen3.8-27B 与 Qwen3.5-9B 冻结基座 + 专用路由头),同日亚马逊 Strands Agents 团队发布 Strands Decider 2B。生成式路线的领先者们没有等「新物种」长大,一周内集体站队同一路线——这既是对类别的确认,也是平台方把决策流量留在自家生态的圈地
- 冷静剂(推断明示):Jev 发布仅三周,「25% 财富 500 强在用」「日处理 1 万亿 token」均为创始人口径,融资谈判与 100 亿估值传闻未获确认;工具型报告显示其目标场景限于有限选项任务,开放生成与长上下文推理并不适用。如果大模型厂商把自家旗舰推理能力顺手做成分流端点(OpenAI 的 Decisions API 正是这个形态),那么 TypeSafe 的先发优势更像「定义披露期的红利」,而不是结构壁垒
本报观察:这条真正的门道在「输出空间的工程学」:Agent 应用的可靠性问题,一大半不在模型聪不聪明,而在输出空间是否收敛——把自由文本换成有限选项集,可复现性、延迟、成本同时改善,这三样恰是自动化最稀缺的。对自己写 Agent 的开发者来说,值得动手验证的是:把你工作流里最高频、选项最少的那类决策(比如「改不改这行」「走哪条分支」)拆出来喂给小模型或 API 端点,实测延迟与准确率——这比争论「决策模型算不算 AI」有用得多。
[DoNews · 10月5日] [千年书 · Decider 2B 拆解 · 10月4日]
AI / 科技 Tech
FreeVideo 发布:8GB 显存的笔记本跑本地视频生成,ComfyUI 插件一键装,Minimax H3 从「服务器级」下放到消费级
- 发布事实:FlashML 在 GitHub 开源 FreeVideo(10 月 4 日 ComfyUI Wiki 报道,HaochengXiUCB 同日发推介绍),形态是 ComfyUI 插件 + Windows 启动器,基于 OpenVDN 的 8 步 VDN-H3 模型、FP8 精度运行,官方口径最低配置 8GB VRAM + 16GB RAM,支持 LoRA 与自定义工作流
- 机制来源(拆解):它不做模型压缩,而是做「内存层级重排」——把 VRAM、系统内存和磁盘当成一个统一存储层级统一调度,按 GPU 架构动态规划权重放置位置、计算精度和注意力内核的取舍;整套 MiniMax H3 模型栈在磁盘上约 42.5GB,靠的是算得快、存得巧,8 步蒸馏的 VDN-H3 又从计算量上砍了一刀
- 定位观察(分析):视频生成的硬件门槛从「4090 级」被打到「轻薄本独显级」,意味着本地视频生成的目标用户从极客转向普通创作者;社区已有 8GB 显存流程实测教程。值得留意的边界是:FreeVideo 跑的是 H3 衍生的 8 步短流程,与云端完整版的质量差没有被官方口径回答——「能用」与「可用」之间仍隔着一档
ComfyUI 已入门你今天就能装插件实测:8GB 显存这条线在现有设备过不过、两分钟短片的质量能否接受,结论直接写进自己的工具箱笔记。
[ComfyUI Wiki · 10月4日] [GitHub 仓库]
Meta 个人助手 Muse 被曝「每小时给每位联系人建档」:亲密程度、关系建议、隐私推断都在里面,Agent 的长记忆边界再一次被外界放大检查
- 曝光事实(10 月 5 日):IT之家转引,Muse 上线不足一个月、下载数百万,用户绑定银行、消息、健康等账户换取代办事能力;多名研究人员通过普通聊天界面提取出其内部运行指令
- 档案情状(机制披露):内部指令显示 Muse 会每小时为每位联系人建立独立档案,内容包含亲密程度、关系建议甚至隐私推断,以此支撑个性化服务;Meta 回应称这些文件本就对外开放(用户可查看),强调数据未做越权获取
- 对 Agent 开发的对照(分析):个性化服务的本质是把「你的社交关系」建成长期记忆,而记忆的透明度、可删除性正是这类产品的伦理盲区;此前 Muse 还被质疑在磁盘权限关闭时读取对话。如果对照自己写过的 Agent 记忆库,那么「存什么、要不要让用户看见并能一键清除」应该当作设计前置项,而不是出事后补丁——这也是当前所有个人 Agent 产品的公共考题
面试聊 Agent 隐私边界时这是现成案例:Muse 用「自动建档」换个性化,恰好反证了记忆透明度设计在简历项目里能讲出的分量。
[IT之家 · 10月5日]
OpenClaw 周更发版并把腾讯 AIG 塞进安全审查管线:双扫描器独立运行 + AI 评审综合,恶意用例正确分类 98.6%
- 发版事实:OpenClaw v2026.9.8 新增 GPT-6.1 Sol 模型支持(限有权限账户),43 个 PR、12 个直接提交、8 位贡献者;修复委托结果与对话绑定、大型 Codex 配置内存占用、Windows 启动等问题;官方插件新增 50+(合作方含 Notion、Canva、Dropbox),可在聊天里直接提出请求安装,插件支持热重载
- 安全管线:OpenClaw 宣布把腾讯混元 AI-Infra-Guard(AIG)集成进开源命令行工具 ClawScan,用于 ClawHub 上所有技能与插件的安全审查。架构是双扫描器独立运行(AIG 与 NVIDIA SkillSpector),再由 AI 评审综合两方发现给出最终结论
- 数字与含义(分析):SpotTrustBench 556 个固定用例子集上,ClawScan 与基准标签匹配率 86.9%、恶意用例正确分类率 98.6%。「多引擎独立扫描 + AI 仲裁」的模式值得抄:既规避单模型面料偏差,又用固定测试集作分母验证——这与 Agent 评测「固定分母 + 失败归因」的思路是同一件事在安全场景的投影
给 agent 生态做供应链安全有一手参照架构了:双扫描 + AI 仲裁 + 固定基准分母,写方案或面试都能直接引用这三个数字。
[iaipie 资讯速览 · 10月5日]
斯坦福 NLP 提出 AC2:让 critic 学好一点、并信任它,LLM 强化学习可以只用部分 rollout——训练提速的新方向
- 方法事实(10 月 5 日):AC2(Actor-Critic with Action Chunking)针对的问题是「LLM 强化学习里每一次 rollout 是否都必须跑完」;它的答案是给 critic 做两件事——把 critic 训得更好,然后信任它,用学到的 critic 对 token 块直接评分,从而只做部分 rollout(partial rollouts),训练速度比 GRPO 更快
- 含义(分析):训练成本的一个大头花在「把没必要的 rollout 跑完」上;如果 critic 的评分足够可信,等于把「完成一次完整生成」这个刚性动作变成了可裁剪的弹性动作。留意边界:目前原文尚未披露具体实验数据、模型规模与适用限制,「提速多少」还测不出来,等 arXiv 原文再入素材库
RL 训练成本方向的新论文,等原文数据出来再决定要不要进简历的知识面;先记假设与机制,别抢记结论。
[iaipie 资讯速览 · 10月5日]
游戏 / 开发圈 Dev
《天国:拯救》制作人希望 GTA6「为游戏涨价开路」:79.99 美元标准版已就位,行业在等头部把价格锚拔起来
- 发言事实(PC Gamer 采访,10 月 5 日中文区落地):Warhorse Studios 联合创始人 Martin Klima 表示,游戏技术与规模不断扩大、开发成本持续攀升,而市场增长已触及天花板,数字发行压缩流通成本的空间所剩无几,维持业务可持续的剩余手段就是提高单款游戏售价——但谁先涨谁挨骂,所以「真正有能力率先涨价的只有 Rockstar 和 Take-Two」,他希望 GTA6 成功、为行业向更高价格带过渡打开缺口。Klima 自称不是 GTA 粉、不打算玩 GTA6,但仍盼它卖好
- 价格坐标:GTA6 美国定价标准版 79.99 美元、终极版 99.99 美元(PC Gamer 评:鉴于限定内容堆料,实质是一款 100 美元的游戏);任天堂此前已将《马力欧卡丁车 世界》北美定价 79.99 美元,时任社长 Doug Bowser 表态「不把 80 美元当统一基准价,而按开发费用与内容规模单独定价」
- 涨价的卡位逻辑(分析):这是典型的「锚定者博弈」——先涨者承担骂名并替全行业测试需求天花板,跟随者只需在锚定之后抬价;70→80 美元这一档若被 GTA6 证明卖得动,那么明年起 3A 标准定价的集体上移几乎是定局。Reddit 社区的反应也是一面镜子:玩家普遍认为 GTA6 因关注度特殊「怎么贵都卖得动」,其他作品未必享有同样特权,「价格与内容不匹配的只有折价一条路」
- 对独立开发的参照(影响推演):头部锚点上移会顺水推舟地抬升玩家的「心理价格带」,对独立游戏实为中性偏利好——21.99 美元档在 80 美元时代显得更「便宜」了。但前提是内容与定价匹配:《天国:拯救》粉丝区的不满(未完成作品、DLC 分割销售里谈提价)说明价格弹性真正约束的是交付质量,不是情怀
独立游戏的定价表该跟着头部锚点重算一遍:80 美元时代 21.99 的相对感会变,但「先看交付完整度再谈涨价」这条纪律对谁都不豁免。
[游民星空 · 10月5日]
FF7 新作宣布全平台首发,总监称「玩家环境变化的必然结果」:PS 独占的经济学开始算不过账了
- 事实(《Edge》杂志第 429 期采访,10 月 6 日中文区发酵):《Final Fantasy 7 Revelation》将是重制系列第一部发售当天全平台同步上线的作品——不再是「PS 独占起步、PC/Xbox/Switch 玩家等数年」。总监滨口直树的原话指向玩家侧变化:玩家「不再被单一硬件绑死」,电视、台式机、掌机之间自由切换,开发者真正要考虑的「不是能用到多高性能的环境,而是能把同一份核心体验多广地送到不同环境」
- 系列轨迹反差:Remake 与 Rebirth 都是 PS 独占开局、移植等了数年;而 Square Enix 早在 2024 年就公开表示「积极推进多平台战略」,这家 90 年代就在任天堂与索尼之间摇摆的公司重新回到了平台中立的旧路上
- 账与代价(分析):3A 成本已高到独占首发等于主动放弃一大块回款周期;当「为玩游戏买一台机器」的门槛撞上玩家的碎片化设备生态,独占换补贴的商业模式覆盖面就崩了。代价同样明确——从顶配 PC 到入门掌机的全平台首发意味着优化工作量陡增,「同一份核心体验」的适配与缩放会成为下一阶段 3A 开发的主战场
- 附带信号:滨口还提到实体媒介最终会走向「基本上无光盘」状态——他个人为这款 JRPG 争取过实体版,但无法给出承诺;发售日与售价尚未公布
「玩家在哪游戏在哪」对独立开发是顺风证词:平台中立 + 移动端适配的成本在结果上更容易被摊薄,抖音小游戏路线没有走错。
[网易号 · 10月6日]
世事 · 人间 World
华为与高通宣布多年期专利交叉许可:中美科技摩擦周期里,头部公司仍以商业条款解决 IP 之争
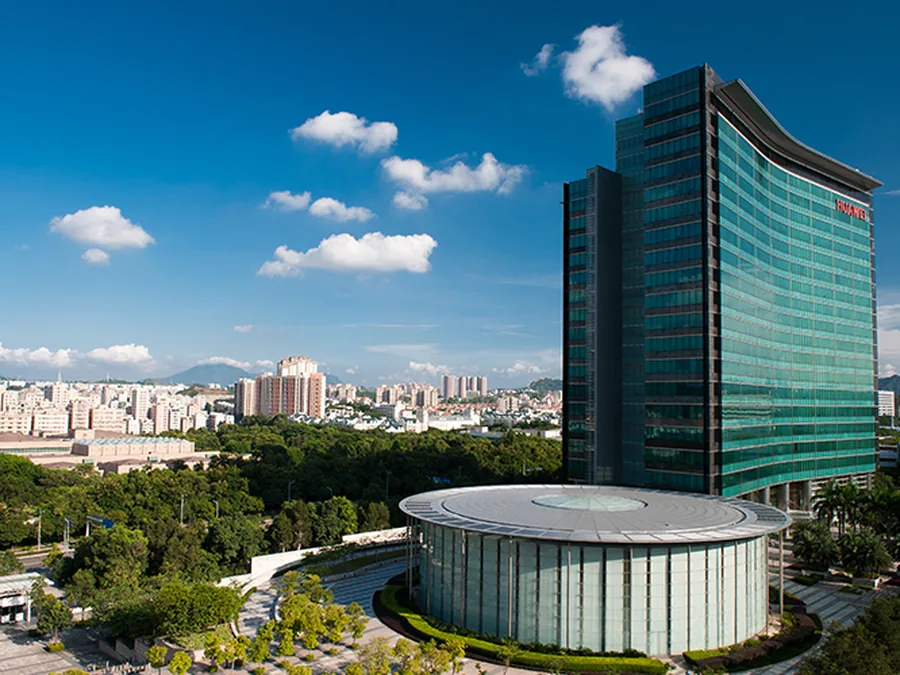
- 官宣事实(10 月 5 日):华为官网发布新闻稿,华为与高通宣布达成一项多年期、广泛的专利许可协议,其中包含交叉许可(cross license);条款金额与细节未公开。新闻稿由华为深圳总部与高通同步发布
- 结构含义(分析,推断明示):交叉许可与单向现金许可费是两种议价结构——前者意味着双方认定对方专利组合对自己的产品线有现实价值,议价地位大体对等;两家此前在 5G 手机时代有过多年许可合约,此番在出口管制与自主芯片转型的敏感时段续签,至少说明「商业条款解决 IP」这条通道在两家之间仍然畅通,摩擦升级的叙事没有覆盖器件层面
- 产业观察角度:手机与终端之外,高通的授权收入模型与华为的车载、PC 扩张线是这项协议未来更值得盯的两个增量场景——许可范围是否覆盖新业务,是判断其结构意义的分水岭
芯片许可的费用结构长期影响终端价格与渠道格局,间接决定小游戏和 AI 应用最终跑在哪台设备上。
[华为官方新闻稿 · 10月5日]
Agent 前沿 · DeepSeek Harness DSH
社区插件一日三发:dsh-code-atlas 给 agent 一张「每文件一行、条条带行号」的可核对仓库地图
- 发布事实(10 月 5 日):qlheric 在 DSH 官方仓库 Show Your Plugins 板块连发 dsh-code-atlas 与 dsh-toolbox 等插件,同期 edisonzerolam 发布 dsh-capability-aware(让 agent 知道这台机器实际能做什么)。code-atlas 与已有符号索引类插件 dsh-code-index 的差异定位在「每文件一行的 F/R/A/S,且每条能指回出处」
- 四列是什么:F=这文件负责什么(文件头注释原文带行号,无注释时以主要导出兜底);R=仓内解析出来的 import 依赖关系,解析不了的相对导入单独列出而不抛异常;A=对外入口(导出符号@行号);S=不能弄错的地方——注释里的纪律词(必须/禁止/IMPORTANT/NEVER)与危险写法(eval、child_process、rm -rf、shell:true、硬编码密钥、关闭 TLS 校验、777),每条带行号
- 防幻觉的两个自觉(分析):S 列只给候选不给结论——它只负责指出「这里有人写过规矩」或「这里出现了危险写法」,判断留给编码者与 agent 自己核对;解析器是增强而不是单点,tree-sitter WASM 拿不到语法文件就退回正则层,每个符号标注来源(tree-sitter / regex)。数据口径:252 个文件、2723 个符号、0.82 秒建完索引
- 一条踩坑实录:初版把 .dsh_probe/ 下克隆的参考仓库也扫了进去,1094 个文件耗时 9.46 秒;加上「点目录默认不扫」这道线后收敛到 252 文件 0.82 秒——「别人的仓库会污染你的地图」,这类边界设定经验对任何做代码索引的人都是通用的
用 DSH 给 2 万行级项目做 agent 工时,结构地图加行号溯源正是上下文瘦身的第一根拐杖;装上对着 IterTrip 仓库试一轮,看 A/S 两列能不能当验收清单用。
[官方仓库 #8965 · 10月5日] [dsh-code-atlas 仓库]
值得关注 Watchlist
日本 1400 亿美元 AI 数据中心投资计划进入第 5 天,仍在持续发酵:JERA × 戴尔 × Rhaelm 千叶县 400MW 项目先行,10/5 日经 225 单日大涨超 1700 点、突破 70000 点
原发 10 月 1 日(FT 中文网报道):三家签署备忘录,首个项目投资超 150 亿美元、采用表后供电不接公共电网,后续五年拟建成 3–4 吉瓦配套燃气发电基础设施,阿波罗提供融资。算力基建的资本叙事从「北美独走」变成「亚太回流」,电力 giants 直接下场成为新变量
[FT 中文网 · 10月1日] [东财号跟进 · 10月5日]
消息称 Reflections 等多家西方企业本月将推出开放权重 AI 模型,开放权重阵营的「西方梯队」正在补位
10 月 5 日媒体援引内部消息(The Information 路线):为准备发布,Reflection 近期持续与华盛顿等地的相关人士沟通。「开源 vs 闭源」的地缘博弈里,西方开放权重模型稀缺的局面若在本月被改写,开源生态的可选基座会多出一批候选
[综合报道 · 10月5日]
2026 年诺贝尔生理学或医学奖揭晓:光遗传学三人组合获奖,脑科学与技术的交叉线再获最高背书
10 月 5 日瑞典卡罗琳医学院宣布,授予美国科学家卡尔·戴塞罗思、德国科学家彼得·黑格曼与格奥尔格·内格尔,表彰其在光门控技术上的贡献;光遗传学是「用光控神经元」的基石技术,也是当前脑机接口与神经调控产业的上游
[中科院 · 10月5日]
📖 本期词汇
决策模型(Decider)不生成自然语言文本、把输入归入预设输出集合(是/否、数值评分、选项分发)的模型类别,机制上依赖「面向校准决策的强化学习」;生成式模型负责复杂推理,决策模型负责高频、有限选项的路由、分类、审批与 Agent 下一步动作——Jev 三周内跑通市场验证,OpenAI/Cloudflare/亚马逊在一周内跟队
F/R/A/S 仓库地图dsh-code-atlas 插件定义的四列元数据:每文件一行 Function(职责原文带行号)、Reference(依赖关系)、API(导出符号@行号)、Safety(纪律词与危险写法带行号);S 列只给候选不给结论,防幻觉设计等价于「机器提供索引、判断留给人」的自觉
光遗传学(Optogenetics)把光敏蛋白转入特定神经元、用光照精确开关神经活动的技术,神经科学实验与脑机接口产业的上游;三位奠基人获 2026 年诺贝尔生理学或医学奖,是 Berry 认知层技术与产业交叉线又一次被最高奖背书
— 完 —